هوش مصنوعی معمولاً با چیزی شناخته میشود که روی صفحه میبینیم: پاسخی به یک پرسش، تصویری تولیدشده یا پیشنهادی برای حل مسئله. اما پشت این خروجی، مجموعهای از پردازندهها، حافظهها، شبکهها، نرمافزارها و مراکز داده کار میکنند. شناخت این زیرساخت کمک میکند بفهمیم AI چگونه ساخته میشود، چرا توسعهٔ آن پرهزینه است و اختیار استفاده از آن چگونه میان شرکتها، نهادها و مردم توزیع میشود.
هوش مصنوعی محصول یک تراشه یا برنامهٔ منفرد نیست. توان آن از هماهنگی اجزایی میآید که هرکدام نقشی متفاوت دارند. همین وابستگی متقابل، AI را به موضوعی فراتر از مهندسی تبدیل میکند: دانش و کارِ ساخت آن گسترده و اجتماعی است، اما مالکیت و قدرت تصمیمگیری دربارهٔ آن میتواند متمرکز باشد.
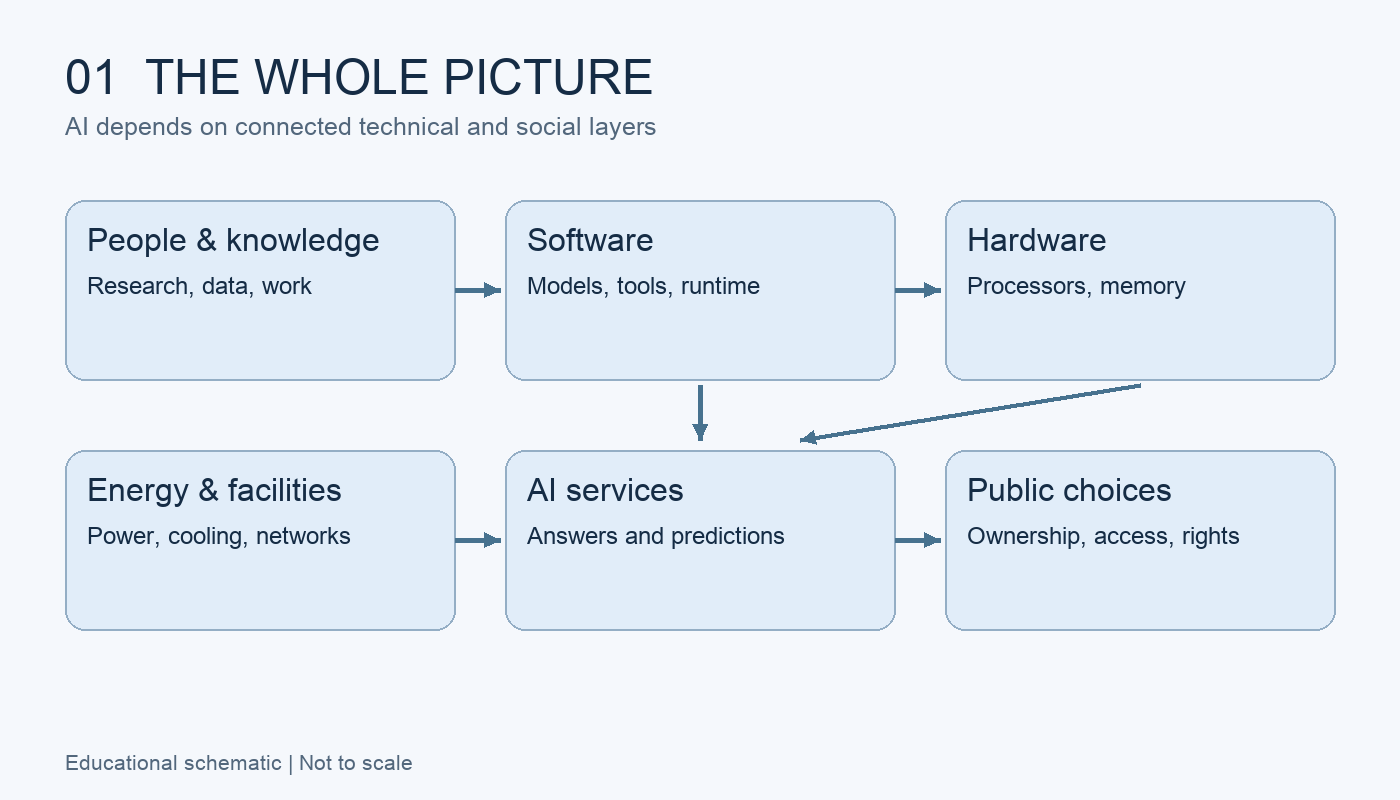
سختافزار چه میکند؟
مدلهای هوش مصنوعی برای آموزش و پاسخگویی به محاسبات عددی نیاز دارند. بسیاری از این محاسبات را میتوان به بخشهایی تقسیم کرد که همزمان انجام شوند. نوع پردازنده، ظرفیت حافظه و سرعت انتقال داده تعیین میکند که این کار با چه سرعت، هزینه و مصرف انرژی انجام شود.
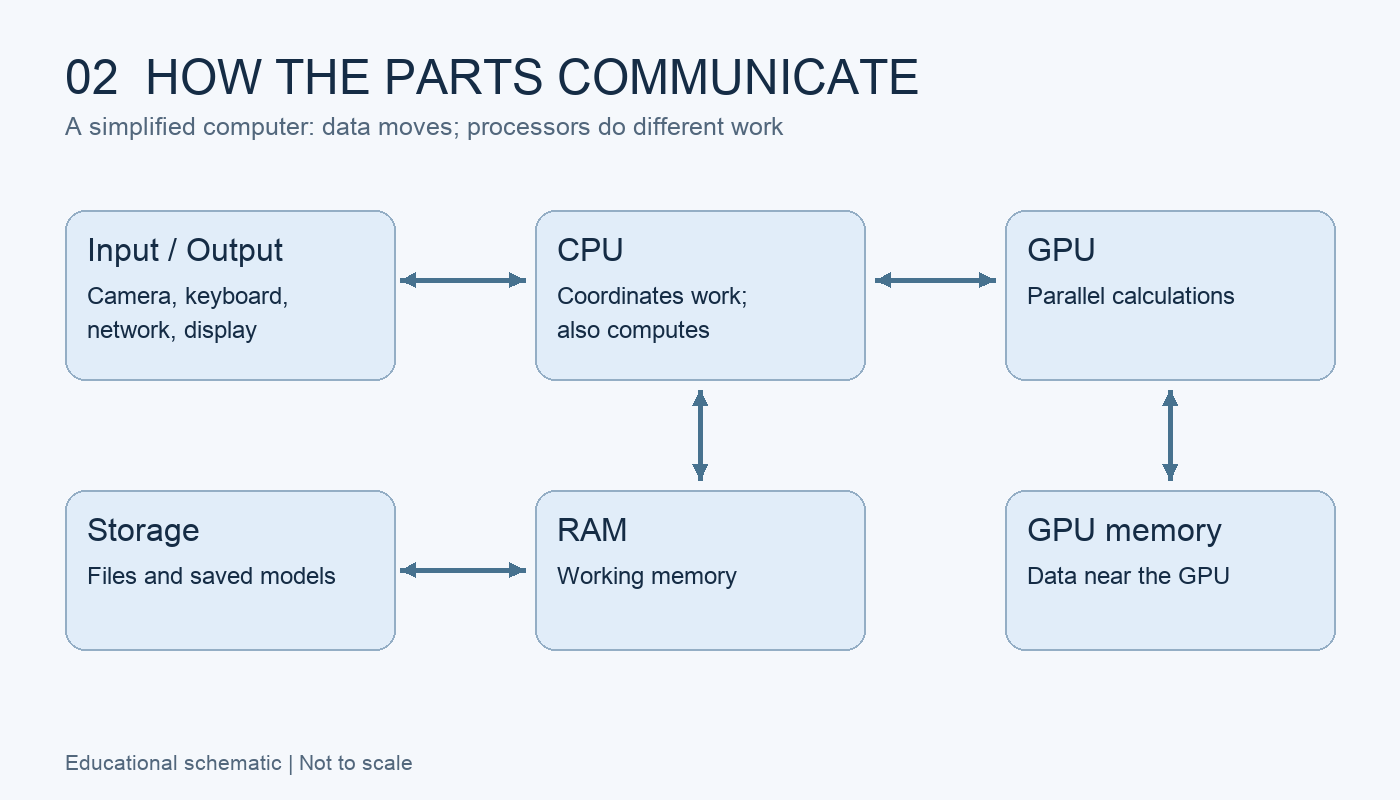
پردازندهٔ مرکزی یا CPU بخش عمومی و انعطافپذیر سامانه است. اجرای برنامهها، آمادهسازی داده و هماهنگی اجزا از کارهای رایج آن است. CPUهای جدید نیز پردازش موازی انجام میدهند؛ تفاوت آنها با GPU، صرفاً «ترتیبی در برابر موازی» نیست، بلکه به معماری و تناسب با نوع کار مربوط میشود. مستندات Intel
پردازندهٔ گرافیکی یا GPU برای انجام تعداد زیادی عملیات مشابه بهصورت موازی مناسب است. این ویژگی در محاسبات ماتریسی شبکههای عصبی اهمیت دارد. بااینحال، قدرت محاسباتی بهتنهایی کافی نیست: اگر داده با سرعت لازم از حافظه به پردازنده نرسد، بخشی از ظرفیت دستگاه بیاستفاده میماند.
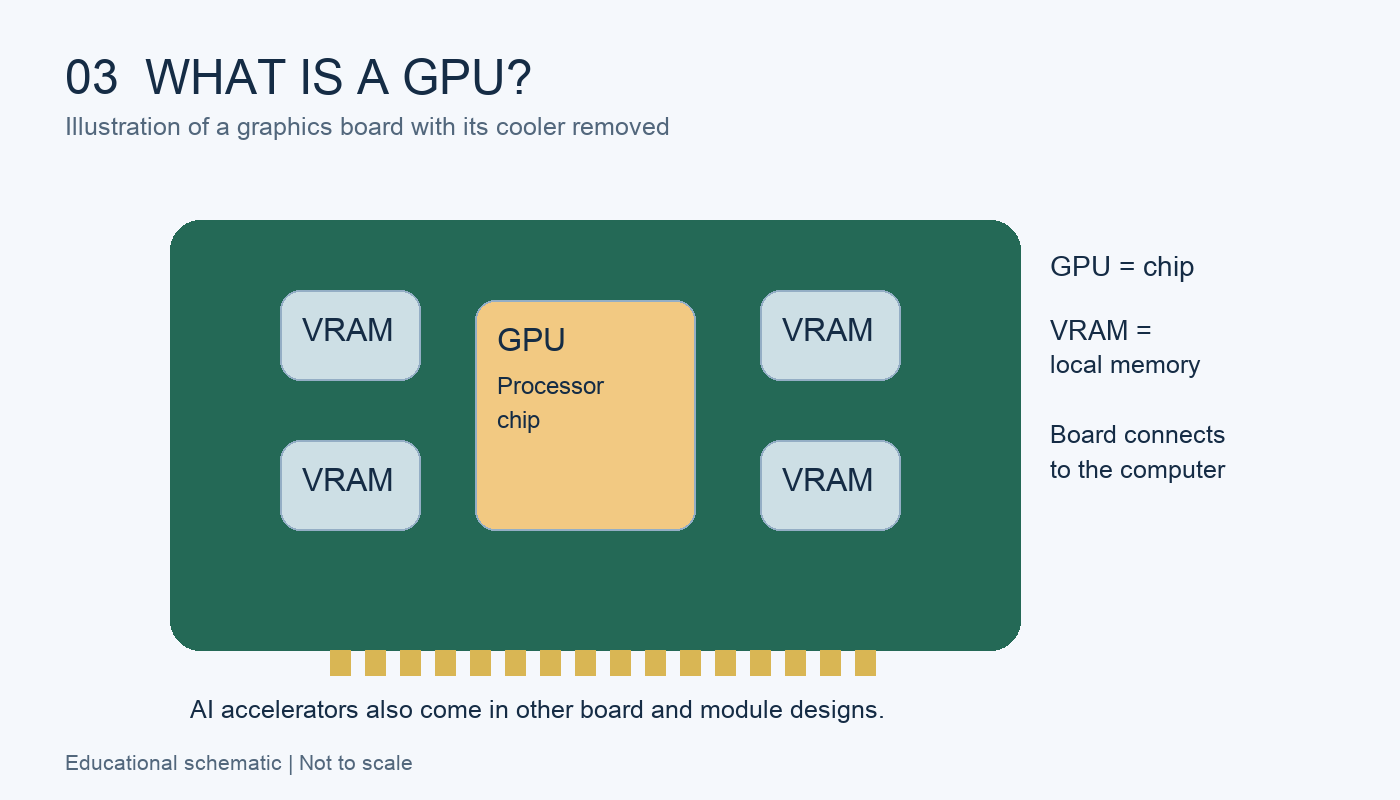
شتابدهندههای تخصصی برای دستهای مشخص از محاسبات طراحی میشوند. TPU نام خانوادهای از شتابدهندههای گوگل است و NPU معمولاً به واحدی برای تسریع عملیات شبکهٔ عصبی گفته میشود. ASIC عنوان کلی مدارِ طراحیشده برای کاربرد خاص است؛ بنابراین این نامها همیشه دستههای جدا و همسطح نیستند. FPGA نیز سختافزاری بازپیکربندیپذیر است که میتوان ساختار منطقی آن را با نیاز کاربرد تطبیق داد.
یک مدل کوچک روی دستگاه شخصی و یک مدل بزرگ در مرکز داده، نیاز یکسان ندارند. در دستگاه شخصی، مصرف باتری و زمان پاسخ مهم است؛ در مرکز داده، ظرفیت حافظه، ارتباط میان دستگاهها، تعداد درخواستها و هزینهٔ بهرهبرداری نیز اهمیت پیدا میکند. انتخاب مناسب، انتخاب متناسب با کار است، نه لزوماً خرید قدرتمندترین تراشه.
نرمافزار چگونه این توان را به کار میگیرد؟
سختافزار بدون نرمافزار نمیداند چه محاسبهای را چگونه انجام دهد. از مدل تا تراشه، چند لایه میانجی وجود دارد.
چارچوبهایی مانند PyTorch و TensorFlow ابزار تعریف و آموزش مدل را فراهم میکنند. توسعهدهنده میتواند ساختار شبکه و روش آموزش را مشخص کند، بدون آنکه همهٔ جزئیات اجرای سختافزاری را از ابتدا بنویسد. کامپایلرها، کتابخانهها و محیطهای اجرا سپس این محاسبات را برای دستگاه هدف آماده میکنند. راهاندازها نیز ارتباط نرمافزار با سختافزار را برقرار میکنند.
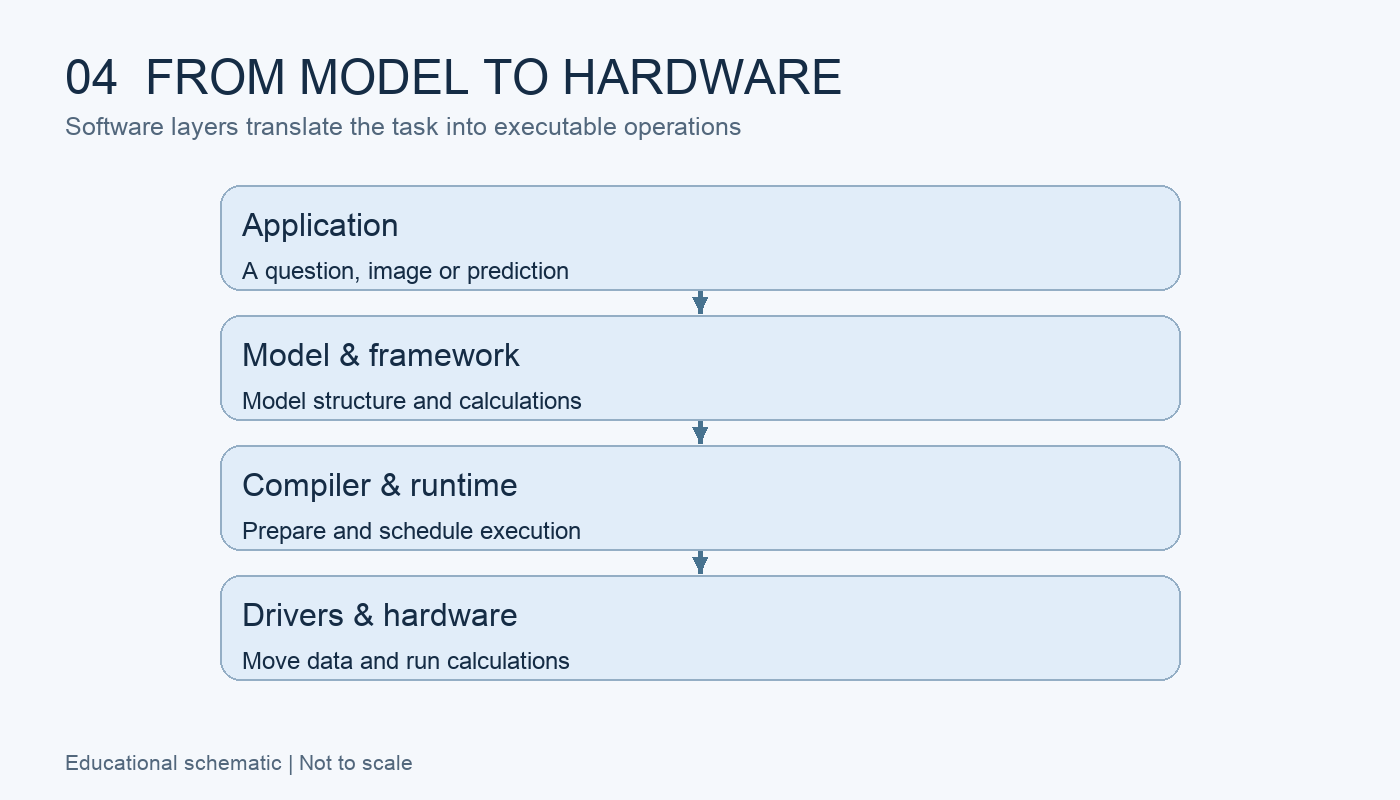
برای نمونه، یک عملیات محاسباتی میتواند با چند روش اجرا شود. انتخاب روش مناسب، نحوهٔ استفاده از حافظه و تقسیم کار میان واحدهای پردازشی، بر سرعت و مصرف منابع اثر دارد. به همین دلیل، دو سامانه با تراشهٔ مشابه ممکن است به دلیل تفاوت نرمافزار و تنظیمات، عملکرد یکسانی نداشته باشند.
بخشی از این بهینهسازی اکنون خود با کمک AI انجام میشود. در پروژهٔ KernelEvolve متا، عامل نرمافزاری نسخههای مختلفی از کد محاسباتی تولید میکند، آنها را میآزماید و با استفاده از بازخورد به جستوجوی راهحل بهتر ادامه میدهد. این نمونه نشان میدهد AI میتواند در توسعهٔ زیرساخت خودش نیز به کار رود؛ البته نتیجه همچنان باید از نظر صحت و عملکرد ارزیابی شود. توضیح فنی متا
چرا انتقال مدل میان پلتفرمها مهم است؟
فرض کنیم یک دانشگاه مدلی را با ابزار و سختافزار مشخصی توسعه داده است. اگر اجرای آن فقط در همان محیط ممکن باشد، تغییر تأمینکننده یا استفاده از تجهیزات ارزانتر دشوار میشود. این وابستگی میتواند هزینهٔ آموزش کارکنان، بازنویسی نرمافزار و نگهداری بلندمدت ایجاد کند.
ONNX برای تسهیل تبادل مدل میان ابزارها شکل گرفته است. این قالب، شیوهای مشترک برای نمایش گراف محاسباتی، عملگرها و انواع داده ارائه میدهد. ONNX Runtime محیط اجرایی مرتبطی است که از مسیرهای مختلف شتاببخشی سختافزاری پشتیبانی میکند. معرفی ONNX و مستندات ONNX Runtime
اما قالب مشترک، اجرای بیدردسر یا سرعت یکسان روی همهٔ دستگاهها را تضمین نمیکند. بعضی عملگرها ممکن است در یک بستر پشتیبانی نشوند یا به تبدیل و تنظیم بیشتر نیاز داشته باشند. انتقالپذیری باید در عمل آزموده شود.
اهمیت اجتماعی استانداردهای باز همینجاست: میتوانند هزینهٔ جابهجایی را کاهش دهند و امکان انتخاب بیشتری ایجاد کنند. بااینحال، بازبودن قالب مدل بهتنهایی دسترسی به تراشه، برق، سرمایه یا ظرفیت مرکز داده را برابر نمیکند.
چه کسانی در ساخت این زیرساخت نقش دارند؟
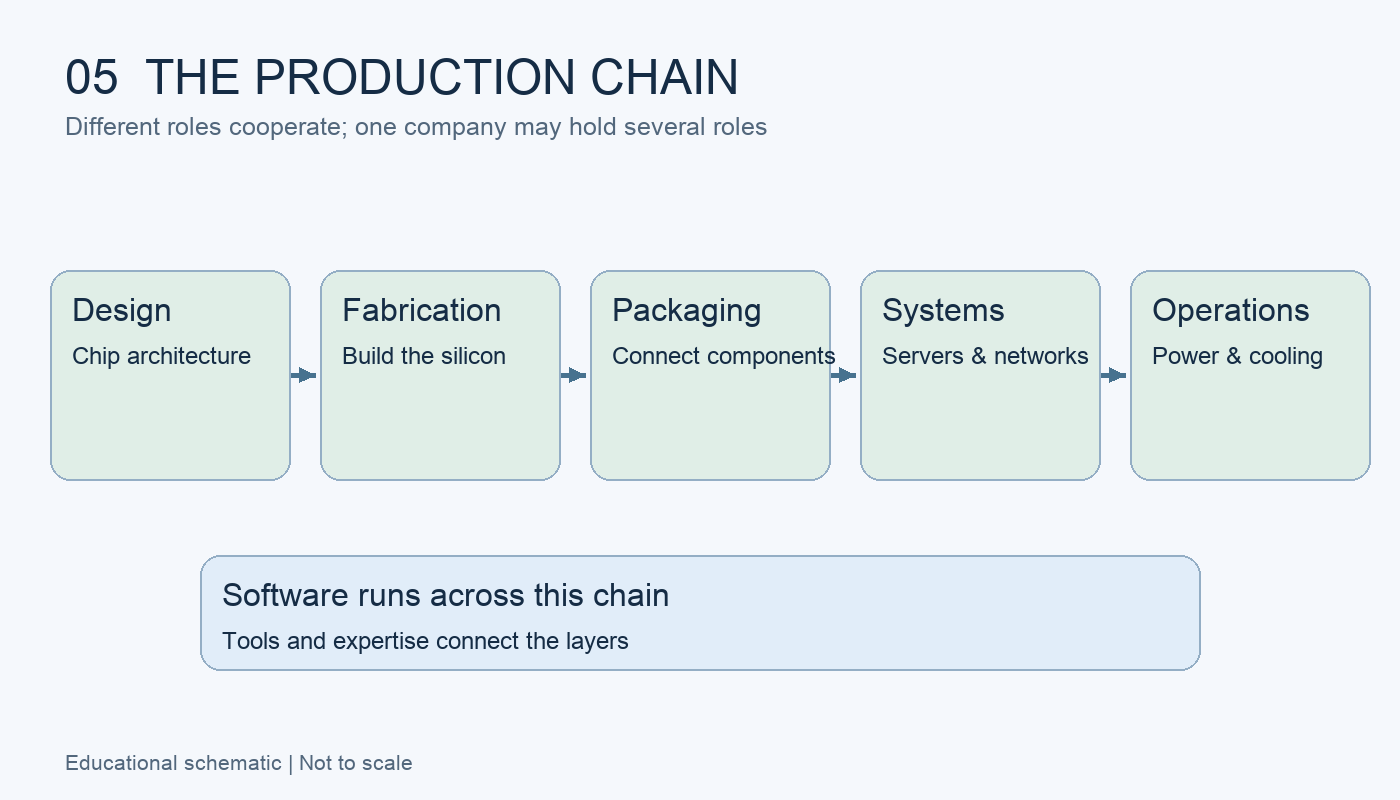
برای شناخت بازیگران، باید میان نقشها تفاوت گذاشت. طراحی پردازنده، ساخت فیزیکی تراشه، بستهبندی، تولید تجهیزات، توسعهٔ نرمافزار و ارائهٔ خدمات ابری، فعالیتهای یکسانی نیستند؛ حتی اگر یک شرکت چند نقش را همزمان بر عهده داشته باشد.
در بخش طراحی و عرضهٔ پردازنده، نامهایی مانند NVIDIA، AMD، Intel و طراحان شتابدهندههای اختصاصی مطرحاند. در بخش نرمافزار، چارچوبها، کتابخانهها و ابزارهای اجرایی تعیین میکنند که توسعهدهندگان چگونه از این سختافزار استفاده کنند. برای فهم جایگاه یک شرکت، باید مجموعهٔ این نقشها را دید، نه فقط نام محصولش را.
ساخت و بستهبندی نیز بخش مستقلی از مسئله است. TSMC برای نمونه، خدمات بستهبندی پیشرفتهای مانند CoWoS و فناوریهای خانوادهٔ 3DFabric ارائه میکند که به کنار هم قرارگرفتن و اتصال اجزای محاسباتی کمک میکنند. بنابراین رسیدن از طراحی به سامانهٔ قابل استفاده، به ظرفیت صنعتی و مهندسی گسترده وابسته است. خدمات بستهبندی پیشرفتهٔ TSMC
مراکز داده، شبکه، حافظه، برق و خنکسازی نیز باید با این اجزا هماهنگ شوند. کمبود یا محدودیت در هر حلقه میتواند بر کل سامانه اثر بگذارد. از این رو، قدرت در اقتصاد AI فقط در مالکیت مدل خلاصه نمیشود؛ کنترل زیرساخت و مسیر دسترسی به آن نیز اهمیت دارد.
آموزش و استفاده از مدل دو مرحلهٔ متفاوتاند
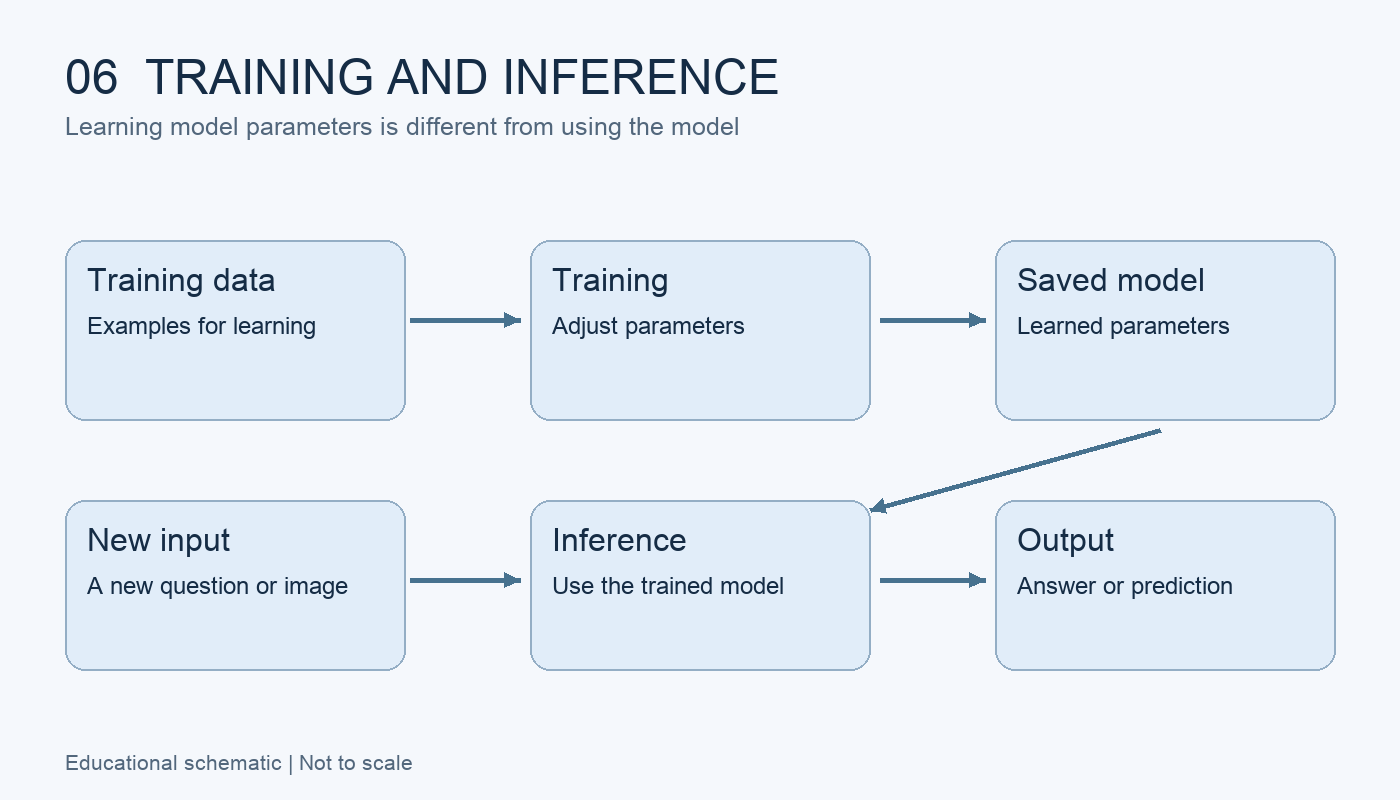
در آموزش، پارامترهای مدل با استفاده از داده و روش یادگیری تنظیم میشوند. در استنتاج، مدل آموزشدیده برای تولید پاسخ، پیشبینی یا تصمیم به کار میرود. این دو مرحله میتوانند نیازهای متفاوتی به حافظه، محاسبه و زمان داشته باشند.
مثلاً سامانهای که باید همزمان به شمار زیادی درخواست پاسخ دهد، تنها با سرعت یک پاسخ سنجیده نمیشود؛ ظرفیت خدمتدهی، هزینه و کیفیت خروجی نیز مهماند. در یک کاربرد تعاملی، تأخیر طولانی ممکن است ابزار را غیرقابل استفاده کند، حتی اگر گذردهی کلی بالایی داشته باشد.
به همین دلیل، عبارتهایی مانند «چند برابر سریعتر» بدون توضیح مدل، سختافزار، تنظیمات و معیار اندازهگیری کافی نیستند. سنجش معتبر باید نشان دهد بهبود در چه شرایطی رخ داده و آیا کیفیت خروجی یا مصرف منابع نیز تغییر کرده است.
بازده بیشتر، الزاماً مصرف کل کمتر نیست
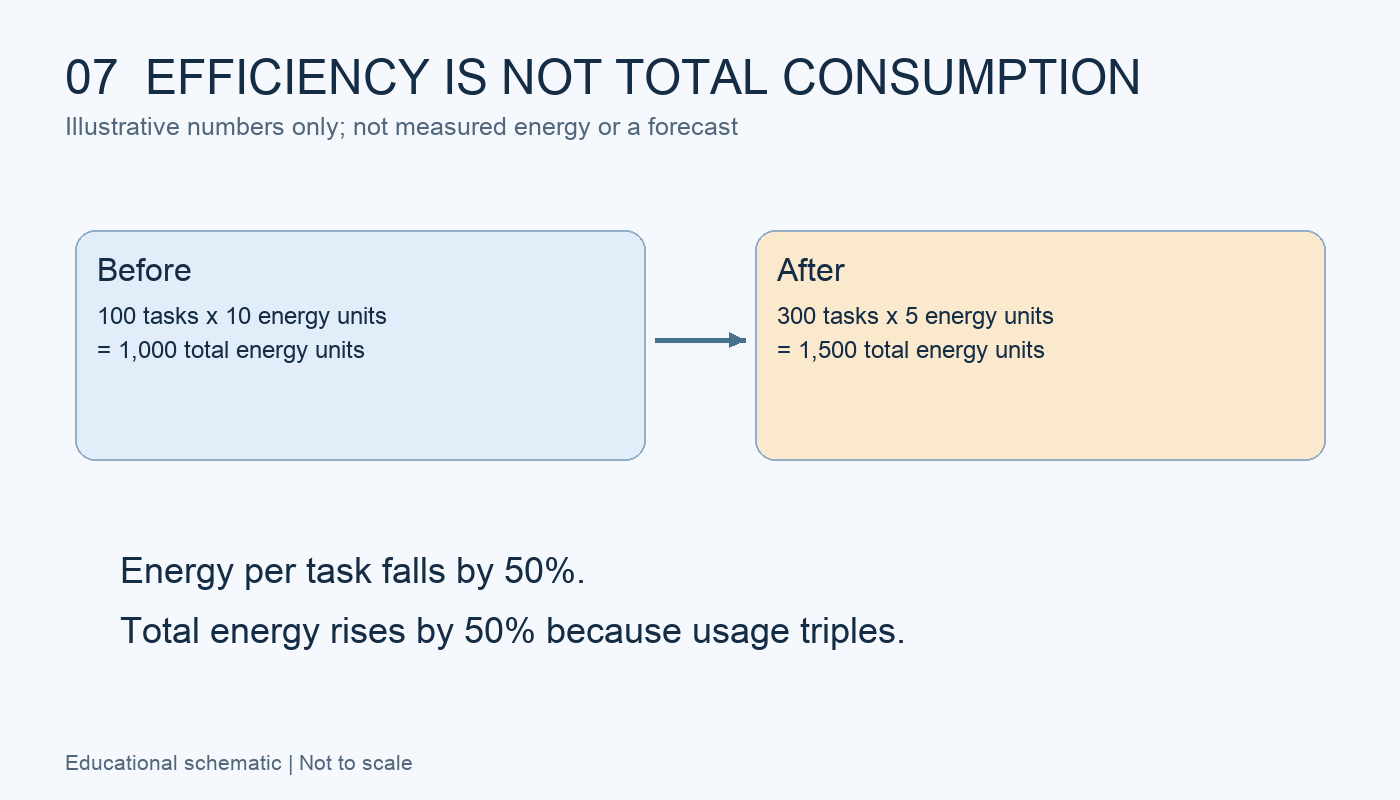
بهینهسازی تراشه و نرمافزار میتواند انرژی لازم برای یک کار معین را کاهش دهد. اما اگر تعداد کاربردها یا اندازهٔ مدلها بیشتر شود، مصرف کل ممکن است همچنان افزایش یابد. باید میان «انرژی هر محاسبه» و «انرژی کل فعالیت» تفاوت گذاشت.
این موضوع AI را به برنامهریزی برق و زیرساخت عمومی پیوند میدهد. توسعهٔ مرکز داده و توسعهٔ شبکهٔ انرژی نیز همیشه با سرعت یکسان پیش نمیروند. گزارش آژانس بینالمللی انرژی نشان میدهد ارزیابی تقاضای AI باید تجهیزات، زیرساخت و مقیاس گسترش را در کنار هم ببیند. انرژی و هوش مصنوعی
پرسش اجتماعی فقط این نیست که یک دستگاه چقدر کارآمد است؛ باید پرسید منابع برای چه هدفی مصرف میشوند، هزینهٔ توسعه را چه کسانی میپردازند و جامعه چگونه در تصمیم دربارهٔ آن مشارکت دارد.
از تولید اجتماعی تا تمرکز اختیار
زیرساخت AI حاصل همکاری گسترده است: پژوهشگر، برنامهنویس، مهندس، کارگر تولید، متخصص شبکه و بسیاری دیگر در آن سهم دارند. دانش و ابزارها نیز بر دستاوردهای پیشین بنا میشوند. از منظر «نظم اجتماعی نوین در عصر آگاهی»، این شبکه نمونهای از ماهیت اجتماعی تولید و شناخت است.
اما گستردگی همکاری، بهخودیخود توزیع برابر قدرت را به دنبال ندارد. مالک یک پلتفرم میتواند دربارهٔ شرایط دسترسی، قیمت، اولویت استفاده و محدودیت خدمات تصمیم بگیرد. اگر تغییر پلتفرم دشوار باشد، اختیار واقعی کاربران نیز محدودتر میشود. این تحلیل، مسئلهٔ فنیِ وابستگی به فروشنده را به مسئلهٔ اجتماعیِ مالکیت و قدرت پیوند میدهد.
همچنین افزایش توان محاسباتی و خودکارسازی توسعهٔ نرمافزار، بهتنهایی تعیین نمیکند که دستاورد آن نصیب چه کسانی شود. ممکن است به کاهش کار فرساینده، خدمات عمومی بهتر و فرصت یادگیری منجر شود؛ یا برای کاهش هزینهٔ نیروی کار و تمرکز بیشتر درآمد به کار رود. جهت استفاده و شیوهٔ توزیع منافع، موضوع تصمیم اجتماعی است.
متنبازبودن و کنترل دموکراتیک
پروژهٔ متنباز میتواند بررسی کد، مشارکت فنی و استفادهٔ مشترک را آسانتر کند. ONNX برای نمونه، نقشها، گروههای تخصصی و کمیتهٔ راهبری دارد. این سازوکارها برای ادارهٔ همکاری فنی مهماند. ساختار حکمرانی ONNX
بااینحال، مشارکت توسعهدهندگان با نمایندگی همهٔ کسانی که از فناوری تأثیر میپذیرند یکسان نیست. کارکنان، کاربران خدمات عمومی و ساکنان مناطق میزبان زیرساخت نیز منافعی دارند که ممکن است در تصمیم فنی بازتاب پیدا نکند.
در چارچوب کتاب، کنترل دموکراتیک یعنی جامعه تنها مصرفکنندهٔ خروجی نباشد؛ بتواند دربارهٔ هدف، حدود استفاده، هزینهها و توزیع دستاوردها نقش مؤثر داشته باشد. شفافیت قراردادهای عمومی، امکان ممیزی مستقل، مشارکت کارکنان و مسیر روشن اعتراض و پاسخگویی، از سازوکارهای پیشنهادی برای تحقق این جهتگیریاند.
شناخت تراشهها و نرمافزارها برای فهم AI ضروری است، اما پایان بحث نیست. پرسش تعیینکننده آن است که این توانِ ساختهشده از دانش و کار اجتماعی، تحت چه نوع مالکیت و نظارتی اداره میشود و چگونه میتواند به افزایش اختیار، رفاه و آگاهی همگانی کمک کند.
فارسیEnglishبازگشت به صفحهٔ اصلی

Leave a comment